Odprtokodni BERT (Google, 2018)
Izvirni naslov vira: BERT v odprti kodi: najsodobnejše predučenje za obdelavo naravnega jezika
Ekipa Google AI Language najavlja odprtokodno izdajo BERT, tehnike predučenja za obdelavo naravnega jezika. BERT je globoko dvosmeren model, vnaprej naučen na neoznačenem besedilu, ki ga je mogoče hitro dodatno učiti na majhnih podatkovnih zbirkah za posamezne naloge. Objava poroča o najboljših doslej doseženih rezultatih pri 11 nalogah obdelave naravnega jezika.
Prispevek
- Le tu: 17
Kaj pravi
- Ekipa Google AI Language najavlja odprtokodno izdajo BERT (Bidirectional Encoder Representations from Transformers), nove tehnike za predučenje modelov za obdelavo naravnega jezika. Objava izhaja iz pomanjkanja označenih učnih podatkov za naloge obdelave naravnega jezika in zamisli, da bi splošne jezikovne predstavitve najprej učili na neoznačenih spletnih besedilih, nato pa jih dodatno učili na majhnih podatkovnih zbirkah za posamezne naloge. Pojasnjuje razliko med modeli, neodvisnimi od konteksta, kot sta word2vec in GloVe, ter kontekstnimi modeli in trdi, da je BERT prva globoko dvosmerna, nenadzorovano naučena predstavitev, vnaprej naučena na navadnem besedilu, kot je Wikipedia. Dvosmerno učenje omogoča zakrivanje nekaterih vhodnih besed, ki jih model nato napoveduje iz konteksta, BERT pa se uči tudi razmerij med povedmi, tako da napoveduje, ali ena poved sledi drugi. Avtorji zasluge za uspešno delovanje pristopa pripisujejo Cloud TPUs in arhitekturi Transformer. Poročajo o rezultatu 93.2% F1 na SQuAD v1.1, ki presega prejšnji najboljši rezultat 91.6% in rezultat na človeški ravni 91.2%, ter o absolutnem izboljšanju za 7.6% na primerjalnem preizkusu GLUE z devetimi nalogami razumevanja naravnega jezika. Dodatno učenje traja nekaj ur ali manj, objavljeni modeli pa so namenjeni samo angleščini. Na voljo so koda, vnaprej naučeni modeli in zvezek Colab, avtorji pa pričakujejo, da večini raziskovalcev modelov ne bo treba učiti od začetka.
- BERT na SQuAD v1.1 dosega 93.2% F1, kar presega prejšnji najboljši rezultat 91.6% in rezultat na človeški ravni 91.2%. u15 F1 je mera točnosti, ki jo objava uporablja za SQuAD.
- BERT na primerjalnem preizkusu GLUE z 9 nalogami razumevanja naravnega jezika izboljša dotlej najboljši rezultat za absolutnih 7.6%. u16
- Objavljeni modeli BERT so namenjeni samo angleščini, avtorji pa upajo, da bodo v bližnji prihodnosti objavili večjezične modele. u17
- Predučenje z napovedovanjem naslednje povedi, za katero je mogoče učne primere ustvariti iz poljubnega besedilnega korpusa, model uči razmerij med povedmi. u13
- Večini raziskovalcev na področju obdelave naravnega jezika, ki uporabljajo BERT, lastnih modelov nikoli ne bo treba učiti od začetka, saj lahko namesto tega dodatno učijo objavljene vnaprej naučene modele. u17 Namenjeno raziskovalcem na področju obdelave naravnega jezika, ki uporabljajo BERT, kot pričakujejo avtorji.
- Vektorske vložitve, neodvisne od konteksta, besedi »bank« pripišejo eno samo predstavitev, ne glede na to, ali se nanaša na bančni račun ali rečni breg, medtem ko BERT besede predstavlja na podlagi konteksta na obeh straneh. u6
- Pri dvosmernem učenju vsake besede ni mogoče preprosto pogojevati z njenimi sosedami, saj bi napovedovana beseda posredno videla samo sebe; zakrivanje vhodnih besed to prepreči. u10–11 Zato so bili prejšnji globoki modeli enosmerni, zakrivanje pa je rešitev, ki jo ponuja objava.
- Cloud TPUs so omogočili hitro eksperimentiranje, odpravljanje napak in prilagajanje modelov, kar je bilo po besedah avtorjev ključno za preseganje obstoječih tehnik predučenja. u14
- BERT pri 11 nalogah obdelave naravnega jezika dosega najboljše doslej dosežene rezultate, skoraj brez sprememb arhitekture omrežja za posamezne naloge. u4–15
- Z BERT lahko vsakdo nauči sistem za odgovarjanje na vprašanja, ki dosega najboljše doslej dosežene rezultate, v približno 30 minutah na eni enoti Cloud TPU ali v nekaj urah na eni enoti GPU. u4
- BERT je predstavljen kot prva globoko dvosmerna, nenadzorovano naučena jezikovna predstavitev, za katere predučenje se uporablja zgolj navadno besedilo, kot je Wikipedia. u5–6
- Avtorji pravijo, da odprtokodna izdaja vsakomur omogoča, da v približno 30 minutah na eni enoti Cloud TPU nauči sistem za odgovarjanje na vprašanja, ki dosega najboljše doslej dosežene rezultate. u4 Vredno je ohraniti kot osrednjo obljubo objave o dostopnosti.
- Objava pravi, da BERT omogoča predstavitev besede na podlagi konteksta pred njo in za njo, in sicer že od najnižje plasti globokega omrežja. u6 Vredno je ohraniti kot najjasnejšo razlago, zakaj je BERT dvosmeren.
- Avtorji trdijo, da BERT skoraj brez sprememb za posamezne naloge presega rezultat na človeški ravni na SQuAD v1.1. u15 Bralec bi morda pričakoval, da model ne bo dosegel rezultata na človeški ravni.
- Dvosmerne modele je bilo prej težko učiti, ker bi model pri napovedovanju besede videl njo samo; objava tudi opozarja, da je zamisel o zakrivanju obstajala že dolgo, preden jo je BERT uspešno uporabil v globokih omrežjih. u10–12 Objava to razreši s pojasnilom, da je bila zamisel o zakrivanju stara in da jo je BERT prvi uspešno uporabil za globoko predučenje.
- Globoko dvosmerno nenadzorovano predučenje na navadnem besedilu prinaša najboljše doslej dosežene rezultate pri obdelavi naravnega jezika z malo spremembami za posamezne naloge, avtorji pa ga objavljajo v odprti kodi. Ali lahko globoko dvosmeren model, vnaprej naučen na neoznačenem besedilu in nato dodatno učen, preseže prejšnje metode obdelave naravnega jezika brez obsežnih sprememb arhitekture za posamezne naloge?
Kako utemeljuje
- thesis Deep bidirectional pre-training yields state-of-the-art NLP results Can a deeply bidirectional model pre-trained on unannotated text, then fine-tuned, outperform prior NLP methods without heavy task-specific architecture changes?
- theme Deep bidirectional pre-training on plain text The source argues that reading words from both sides of their context, learned from unannotated text, gives better representations than earlier one-directional or context-free methods.
- theme State-of-the-art results with little change The source shows that one pre-trained model, fine-tuned with almost no architecture changes, beats prior methods on many benchmarks, including the human-level SQuAD score.
- theme Cheap training and open release The source argues that the released models make state-of-the-art training cheap and accessible, so most users only need fine-tuning, with the limit that the models are English-only.
Vir, odlomek za odlomkom
- u1 November 2, 2018
- u2 Posted by Jacob Devlin and Ming-Wei Chang, Research Scientists, Google AI Language
- u3 One of the biggest challenges in natural language processing (NLP) is the shortage of training data. Because NLP is a diversified field with many distinct tasks, most task-specific datasets contain only a few thousand or a few hundred thousand human-labeled training examples. However, modern deep learning-based NLP models see benefits from much larger amounts of data, improving when trained on millions, or billions, of annotated training examples. To help close this gap in data, researchers have developed a variety of techniques for training general purpose language representation models using the enormous amount of unannotated text on the web (known as pre-training). The pre-trained model can then be fine-tuned on small-data NLP tasks like question answering and sentiment analysis, resulting in substantial accuracy improvements compared to training on these datasets from scratch.
- u4 This week, we open sourced a new technique for NLP pre-training called Bidirectional Encoder Representations from Transformers, or BERT. With this release, anyone in the world can train their own state-of-the-art question answering system (or a variety of other models) in about 30 minutes on a single Cloud TPU, or in a few hours using a single GPU. The release includes source code built on top of TensorFlow and a number of pre-trained language representation models. In our associated paper, we demonstrate state-of-the-art results on 11 NLP tasks, including the very competitive Stanford Question Answering Dataset (SQuAD v1.1).
- u5 BERT builds upon recent work in pre-training contextual representations — including Semi-supervised Sequence Learning, Generative Pre-Training, ELMo, and ULMFit. However, unlike these previous models, BERT is the first deeply bidirectional, unsupervised language representation, pre-trained using only a plain text corpus (in this case, Wikipedia).
- u6 Why does this matter? Pre-trained representations can either be context-free or contextual, and contextual representations can further be unidirectional or bidirectional. Context-free models such as word2vec or GloVe generate a single word embedding representation for each word in the vocabulary. For example, the word “bank” would have the same context-free representation in “bank account” and “bank of the river.” Contextual models instead generate a representation of each word that is based on the other words in the sentence. For example, in the sentence “I accessed the bank account,” a unidirectional contextual model would represent “bank” based on “I accessed the” but not “account.” However, BERT represents “bank” using both its previous and next context — “I accessed the ... account” — starting from the very bottom of a deep neural network, making it deeply bidirectional.
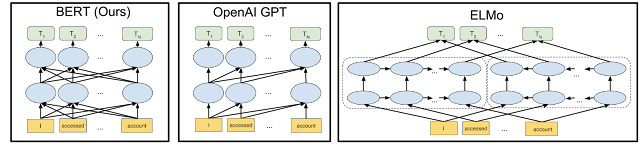
- u7 A visualization of BERT’s neural network architecture compared to previous state-of-the-art contextual pre-training methods is shown below. The arrows indicate the information flow from one layer to the next. The green boxes at the top indicate the final contextualized representation of each input word:
- u8 BERT is deeply bidirectional, OpenAI GPT is unidirectional, and ELMo is shallowly bidirectional.
- u9 Architectural comparison of neural network structures for BERT, OpenAI GPT, and ELMo language models using blocks. (photo)
Architectural comparison of neural network structures for BERT, OpenAI GPT, and ELMo language models using blocks. - u10 If bidirectionality is so powerful, why hasn’t it been done before? To understand why, consider that unidirectional models are efficiently trained by predicting each word conditioned on the previous words in the sentence. However, it is not possible to train bidirectional models by simply conditioning each word on its previous and next words, since this would allow the word that’s being predicted to indirectly “see itself” in a multi-layer model.
- u11 To solve this problem, we use the straightforward technique of masking out some of the words in the input and then condition each word bidirectionally to predict the masked words. For example:
- u12 While this idea has been around for a very long time, BERT is the first time it was successfully used to pre-train a deep neural network.
- u13 BERT also learns to model relationships between sentences by pre-training on a very simple task that can be generated from any text corpus: Given two sentences A and B, is B the actual next sentence that comes after A in the corpus, or just a random sentence? For example:
- u14 Everything that we’ve described so far might seem fairly straightforward, so what’s the missing piece that made it work so well? Cloud TPUs. Cloud TPUs gave us the freedom to quickly experiment, debug, and tweak our models, which was critical in allowing us to move beyond existing pre-training techniques. The Transformer model architecture, developed by researchers at Google in 2017, also gave us the foundation we needed to make BERT successful. The Transformer is implemented in our open source release, as well as the tensor2tensor library.
- u15 To evaluate performance, we compared BERT to other state-of-the-art NLP systems. Importantly, BERT achieved all of its results with almost no task-specific changes to the neural network architecture. On SQuAD v1.1, BERT achieves 93.2% F1 score (a measure of accuracy), surpassing the previous state-of-the-art score of 91.6% and human-level score of 91.2%:
- u16 BERT also improves the state-of-the-art by 7.6% absolute on the very challenging GLUE benchmark, a set of 9 diverse Natural Language Understanding (NLU) tasks. The amount of human-labeled training data in these tasks ranges from 2,500 examples to 400,000 examples, and BERT substantially improves upon the state-of-the-art accuracy on all of them:
- u17 The models that we are releasing can be fine-tuned on a wide variety of NLP tasks in a few hours or less. The open source release also includes code to run pre-training, although we believe the majority of NLP researchers who use BERT will never need to pre-train their own models from scratch. The BERT models that we are releasing today are English-only, but we hope to release models which have been pre-trained on a variety of languages in the near future.
- u18 The open source TensorFlow implementation and pointers to pre-trained BERT models can be found at http://goo.gl/language/bert. Alternatively, you can get started using BERT through Colab with the notebook “BERT FineTuning with Cloud TPUs.”
- u19 You can also read our paper "BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding" for more details.
- u20 × ❮ ❯
- u21 ×
V okolici
Stanford CME295 Transformers & LLMs | Jesen 2026 | Predavanje 2 – Veliki jezikovni modeli
Veliki jezikovni modeli temeljijo na transformerjih, pri čemer je poleg pristopov, ki temeljijo na predstavitvah, kot je BERT, prevladujoča postala uporaba modelov zgolj z dekodirnikom za generiranje besedila. Njihova učinkovitost je odvisna od uravnoteženja velikosti modela in učnih podatkov, uporabe učinkovitih arhitektur ter izbire primernih metod dekodiranja. Tehnike pozivanja in sklepanja lahko izboljšajo odgovore brez spreminjanja uteži, vendar lahko daljši konteksti poslabšajo priklic informacij in povečajo stroške.
Video
To besedilo je napisano z umetno inteligenco.
Objavljeno v: Zdaj